Benchling distingue les requêtes interactives adressées aux agents d’IA des analyses continues de grands volumes de données scientifiques. Sa nouvelle fonctionnalité connecte en continu la plateforme de R&D à Snowflake.
Un agent d’IA peut avoir besoin de retrouver un élément de contexte scientifique au moment où il répond à une question. Mais les équipes de R&D doivent également pouvoir analyser de grands volumes de données, les croiser avec d’autres sources et les réutiliser dans des workflows de modélisation. Benchling sépare ces usages avec Direct Data Share, une fonctionnalité de connexion continue à Snowflake.
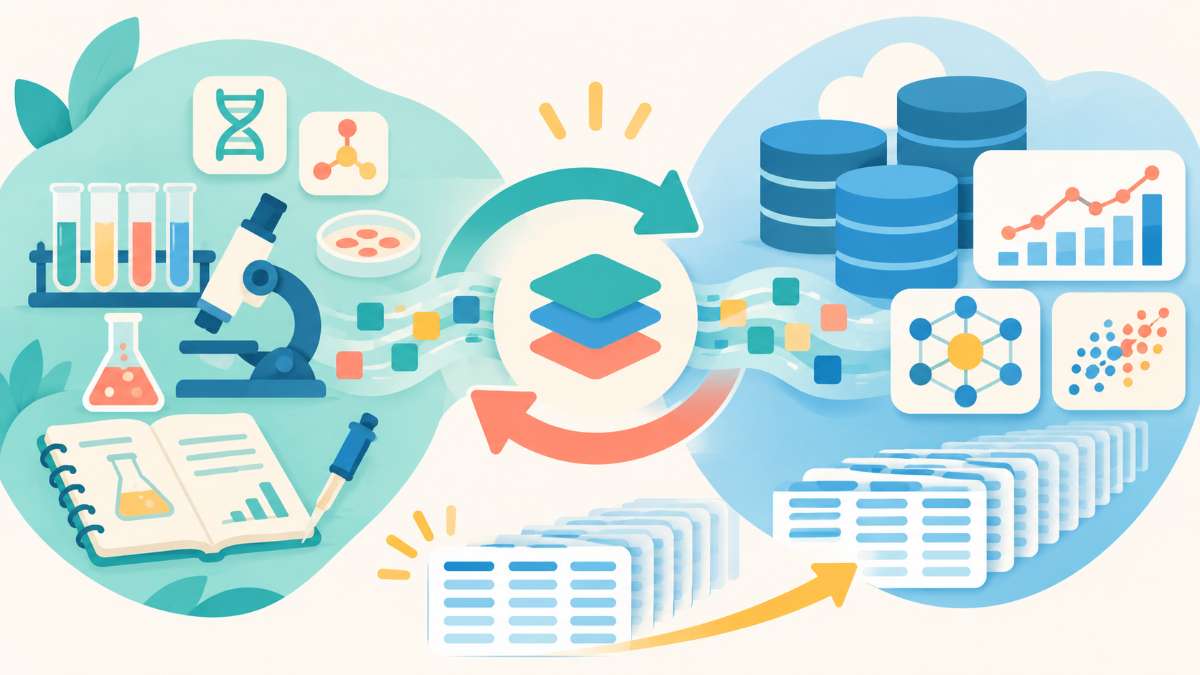
Les AI Connectors de Benchling, lancés plus tôt cette année, répondent aux besoins interactifs. Un agent ou une application d’IA peut récupérer le contexte scientifique utile au moment où il en a besoin. Direct Data Share vise, de son côté, des analyses continues à grande échelle. Des millions de lignes peuvent être interrogées directement, rapprochées de données issues d’autres systèmes, puis exploitées dans des workflows d’analyse et de modélisation. Pour cela, la fonctionnalité maintient un flux bidirectionnel entre Benchling et l’environnement Snowflake de l’entreprise. Les données expérimentales enregistrées dans la plateforme de R&D sont transférées sous forme de tables prêtes à être interrogées et actualisées en quelques minutes. Les données d’instruments, d’essais, de calculs ou de sources tierces présentes dans Snowflake peuvent aussi être intégrées à Benchling, avec les expériences et leur contexte scientifique.
La configuration repose sur une connexion unique du compte Snowflake à Benchling. Les équipes informatiques et data n’ont pas à créer ni à maintenir un pipeline d’export spécifique lorsque le modèle de données scientifiques évolue. Les administrateurs définissent les personnes autorisées à lancer les synchronisations et à gérer les connexions, afin de répondre aux exigences de sécurité et de conformité.
Les analyses et les modèles peuvent exploiter les données expérimentales dans Snowflake, puis transmettre leurs résultats aux chercheurs. Ceux-ci retrouvent ces informations dans leur environnement de R&D, aux côtés du contexte des expériences. Pour Benchling, le partage continu des données et les connecteurs d’IA interviennent donc à des étapes différentes : l’un alimente des traitements réguliers sur de grands volumes, les autres fournissent à la demande des informations utiles à une interaction. « L’IA ouvre de nouvelles perspectives en R&D, mais elle a besoin d’une structure complète et cohérente pour exprimer tout son potentiel », déclare Derek Halliday, Head of Product chez Benchling. « Le temps nécessaire pour synchroniser les données entre deux sources ne doit pas freiner une prise de décision efficace. Avec Direct Data Share, Benchling maintient les données des chercheurs à jour de façon fluide, afin d’aider les équipes scientifiques et informatiques à répondre aux besoins des laboratoires de demain. »